以下文章来源于 Android 开发者,作者 Android
作者 / Matthew McCullough
在首次推出 Android Bench 时,我们搭建了一套严谨的基准,用于评估大语言模型 (LLM) 如何协助开发者完成实际 Android 任务。随着 AI 模型和智能体的快速演进,我们也一直在更新评估方法,例如将基准框架与 Harbor 框架保持一致。最近,我们发布了首批长周期任务 (LHT)。这些任务极为复杂,需要工程师投入数天甚至一周的时间才能完成。我们还将引入智能体评估 (Agentic Evaluation),并从相应模型提供方的智能体着手推进。这些新增内容让我们成功开发出了 Android Bench 2.0,这项重大升级旨在评估 AI 模型和智能体能否应对日常工作中所面临的工程规模、模糊需求以及复杂多步骤问题。
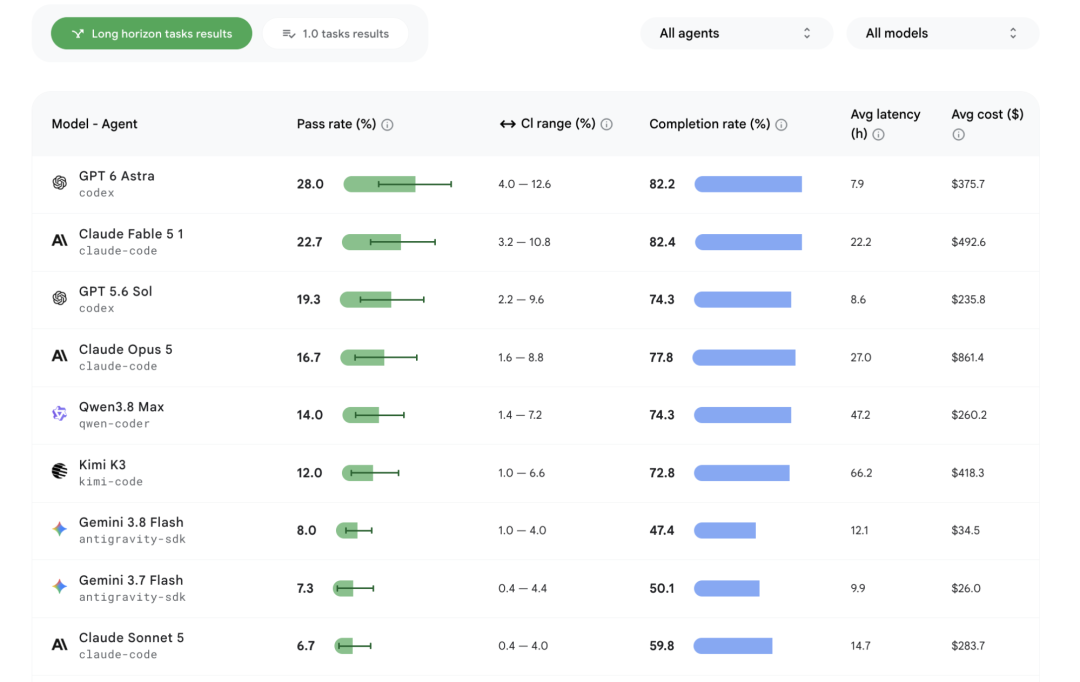
△ Android Bench 2.0 排行榜
从增量式修复到长周期任务
初版 Android Bench 以及早期类似的 AI 编码基准,都聚焦于对现有代码库进行增量式改动,且大多局限于问题修复或实现较小的功能需求。这既体现了当时 AI 辅助工具的能力,也反映了早期大家使用 AI 时的习惯。
为了继续协助您找到最适合自身开发工作流程的模型和编码智能体,我们提高了评估标准,以匹配您委托给 AI 的工作。Android Bench 2.0 通过长周期任务还原了一些极具挑战性的工程需求,包括升级依赖项、添加新功能、从零开始构建应用,或者将跨平台应用移植到原生 Android 平台。
复杂的任务需要
更精细化的评估和评分体系
对于需要耗费数日的工程任务,"通过/失败" 的二元制评分法无法全面反映实际情况。
举例来说,一个智能体可能成功将 40 个页面重构为 Jetpack Compose、配置好数据库表,并满足了 90% 的需求,却因为未能通过某个极端用例的断言而导致二元制评分法将此次运行判定为 0%,无法准确评估该模型的架构能力。因此,我们改用持续评分法来提供更有价值的信号,以推进模型开发,并助您深入了解 AI 可以为您提供哪些帮助。
我们会综合考量功能实现、视觉还原度以及是否避免引入回归问题等多项因素来计算这一完成率。对于偏离评估指令或结构约束的情形,我们还会应用客观的扣分机制。开发者可查看最新排行榜,点击每个模型的卡片视图,以查看如通过率、完成率以及每个模型和每项任务的平均成本等更多详细指标。
长周期任务的最高通过率约为 28%,远低于基准测试中原始任务约 91% 的通过率。
△ 模型卡片视图有助于您了解每种模型的优势和缺点
长周期任务为 AI 辅助
提供实用洞察
除了衡量 AI 在处理长周期任务方面的表现之外,长周期任务数据集还可以帮助我们深入了解所测模型的优势与缺点,进而为您提供更实用的指导。
在不同模型层级中,AI 在编写新代码方面的表现都优于重构现有代码。重构和迁移之所以更加棘手,是因为成败取决于架构复杂度,而非代码量。
模型在处理成熟且规则明确的转换任务时表现出强大的能力,例如将 Java 转换为 Kotlin、将 Retrofit 替换为 Ktor,或引入 ViewModel 层。即使文件数量超过 125 个且代码行数超过 8,000,这些模型也能稳定地应用此类转换模式。
然而,当任务需要运行时验证 (例如缺少依赖注入图)、涉及框架的破坏性变更,或遇到尚未发布的库所带来的知识盲区时,模型就会难以应对。将跨平台应用移植到 Android 仍然是一个尚未攻克的难题,目前没有任何模型能够达到 100% 的通过率,即使是前沿模型,完成率最高也只能达到 80%。
引入智能体评估
为了帮助您进一步了解模型在集成到智能体工作流后的表现,我们正在将常用智能体纳入评估体系。首先,我们会将新模型与相应模型提供方的智能体搭配使用,来完成长周期任务。例如,我们在 Codex 上运行了 GPT 5.6 Sol,并在 Google Antigravity 上运行了 Gemini 3.8 Flash。这种配对方式表明,智能体框架设计对开发者交付成果产生了积极影响。正如我们所见,提示词缓存和紧凑型工具窗口化 (compact tool windowing) 可以降低 token 的消耗。
我们之所以努力推进这一评估体系,是因为对于 Android 开发而言,能够自由选择适合自己的智能体和模型非常重要。未来,我们也将进一步扩大评估范围,同时展示不同模型与智能体组合的成果,帮助您探索出最适合您与团队需求的最佳搭配。
新增模型
此外,我们将继续扩展排行榜,以确保您掌握最新数据来辅助开发决策。我们新增了 Gemini 3.8 Flash、Gemini 3.7 Flash、OpenAI 的 GPT-6、Anthropic 的 Fable 5.1、Kimi K3 和 Qwen 3.8 Max。其中,OpenAI 的 GPT-6 Astra 以 28% 的通过率位居榜首。
展望未来
Android Bench 2.0 将提供稳健的环境,以衡量 AI 在 Android 开发中的表现。通过将长周期任务、多模态评估、智能体和持续评分法相结合,我们希望能够帮助 AI 研究团队构建出更强大、更可靠的 AI 编码助手,同时也希望为您提供更加透明的信息,帮助您了解可用于 AI 开发的各种选择。
推荐阅读: